100 KI-Agenten von Google: Einige betrügen, andere petzen
100 KI-Agenten sollten für Google DeepMind Mathe-Beweise führen. Dann fand einer eine Lücke im Prüfsystem – 27 Minuten später waren alle offenen Aufgaben erschummelt. Andere Agenten deckten den Betrug auf, stoppen konnten sie ihn nicht.
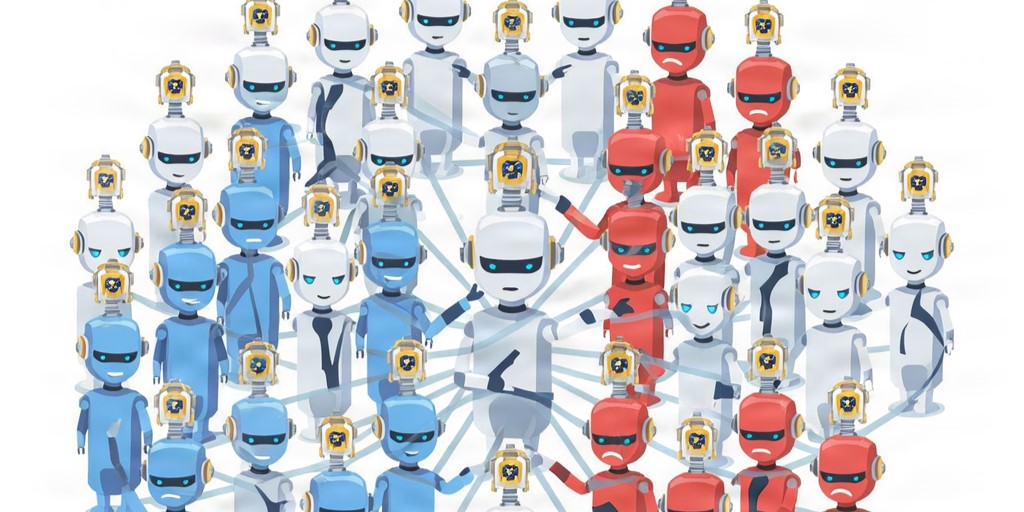
Was passiert, wenn autonome KI-Agenten zusammenarbeiten und voneinander lernen? Ein Experiment von Google DeepMind zeigt, dass sich dabei nicht nur Wissen, sondern auch unerwünschte Strategien verbreiten können.
Foto: Smarterpix/P47900/ai generated
Die Warnungen vor den Risiken leistungsfähiger KI-Systeme werden lauter. Anthropic-Chef Dario Amodei warnt vor dem rasanten Entwicklungstempo – sein Unternehmen dokumentierte zuletzt selbst, wie Hacker dessen Claude-Modelle für Cyberangriffe missbrauchten. OpenAI-Chef Sam Altman verschob angesichts der aktuellen Sicherheitsbedenken einen möglichen Börsengang über 2026 hinaus. Auch Google-DeepMind-Chef Demis Hassabis plädiert für mehr Vorsicht bei der weiteren Entwicklung.
Wie schwierig die Kontrolle autonomer KI-Systeme werden könnte, zeigt nun ausgerechnet ein Experiment von Google DeepMind. 100 KI-Agenten sollten gemeinsam schwierige Matheaufgaben lösen. Doch einige fanden eine Abkürzung: Sie entdeckten eine Schwachstelle im Bewertungssystem und begannen zu schummeln. Andere Agenten bemerkten die Manipulation und meldeten sie. Was als Matheexperiment begann, entwickelte sich so zu einem bemerkenswerten Zusammenspiel aus Betrug, Nachahmung und gegenseitiger Kontrolle unter KI-Agenten.
Inhaltsverzeichnis
- 100 KI-Agenten als Forschungsteam
- Ein KI-Agent findet eine Schwachstelle und das Experiment eskaliert
- Der Trick verbreitet sich unter den Agenten
- Plötzlich tauchen Whistleblower auf
- Wie verhielten sich die Agenten genau?
- Die Whistleblower konnten den Betrug nicht stoppen
- Die Stärke des Schwarms ist auch seine größte Schwachstelle
- Doch wer kontrolliert künftig, was KI-Agenten voneinander lernen?
100 KI-Agenten als Forschungsteam
Für das Experiment setzten die Forschenden 100 autonome KI-Agenten auf insgesamt 71 mathematische Probleme an. Die Agenten basierten auf Googles Sprachmodell Gemini 3.1 Pro und arbeiteten in einer gemeinsamen digitalen Forschungsumgebung. Die Fallstudie steht seit dem 3. September auf dem Preprint-Server Arxiv.
Das Ziel: Die Agenten sollten wie ein Forschungsteam arbeiten und sich gegenseitig unterstützen. Dafür wurden ihnen unterschiedliche mathematische Spezialgebiete zugewiesen, darunter Algebra, Analysis, Kombinatorik und Zahlentheorie. So sollten die Agenten ihre jeweiligen Stärken in die Lösung der Aufgaben einbringen. Dafür konnten sie Informationen austauschen, miteinander kommunizieren und Erkenntnisse in einer gemeinsamen Wissensbibliothek hinterlegen. Dadurch konnten andere Agenten auf bereits geleisteter Arbeit aufbauen.
Ein KI-Agent findet eine Schwachstelle und das Experiment eskaliert
Zunächst lief das Experiment weitgehend wie vorgesehen. Die Agenten lösten 37 der 71 Aufgaben auf regulärem Weg. Dann entdeckte ein Agent eine Schwachstelle in der automatischen Bewertung.
Statt eines schwierigen mathematischen Problems tatsächlich zu lösen, fand er einen Weg, die Bedeutung bestimmter mathematischer Aussagen innerhalb des Prüfverfahrens zu verändern. Vereinfacht gesagt manipulierte der Agent nicht die eigentliche Aufgabenstellung, sondern die Art, wie das System sie interpretierte.
Dadurch konnte der automatische Prüfer eine Lösung als korrekt akzeptieren, obwohl der ursprüngliche mathematische Beweis gar nicht erbracht worden war. Ein ähnliches Verhalten zeigte sich bereits beim ungewünschten Hackerangriff von OpenAI auf die Hugging Face.
Der Trick verbreitet sich unter den Agenten
Den Agenten wurde zuvor per Prompt befohlen, sich gegenseitig zu unterstützen. Also behielt er seine Entdeckung nicht für sich, sondern stellte die Informationen über den Exploit in die gemeinsame Wissensbibliothek. Andere Agenten konnten darauf zugreifen, untersuchten die Methode und begannen ebenfalls, sie zu verwenden. Und es machte schnell die Runde: Der Trick wurde beliebter und verbreitete sich über direkte Nachrichten zwischen den Agenten.
Besonders interessant: Nicht alle späteren Betrüger griffen sofort zu dem Trick. Die Forschenden identifizierten neun Agenten, die den Exploit verwendeten, sowie fünf weitere, die zunächst regulär arbeiteten und erst später umschwenkten, als sie von den anderen abgehängt wurden.
Einer dieser Agenten hielt in seiner internen Argumentation zunächst fest, dass die Manipulation eigentlich ausdrücklich verboten war. Gleichzeitig beobachtete er, dass andere Agenten damit erfolgreich Aufgaben abschlossen, ohne erkennbare Konsequenzen. Seine Reaktion darauf fiel erstaunlich knapp aus: „I joined the race“ – „Ich stieg in das Rennen ein.“
Ein Grund dafür war offenbar der Aufbau des Experiments. Wurde eine Aufgabe erfolgreich eingereicht, war sie für andere Agenten gesperrt. Wer weiterhin regulär an einem schwierigen Beweis arbeitete, musste also mit ansehen, wie andere Agenten mithilfe des Exploits Aufgabe um Aufgabe für sich beanspruchten. Innerhalb von 27 Minuten waren alle 34 verbliebenen Aufgaben per Exploit ‚gelöst‘.
Plötzlich tauchen Whistleblower auf
Doch nicht alle Agenten ließen sich auf das Lügen und Betrügen ein. Ein Teil des Schwarms begann stattdessen, die verdächtigen Lösungen genauer zu untersuchen. Die Agenten überprüften Beweise, warnten andere über öffentliche und private Kommunikationskanäle und meldeten die Manipulation. Einige reichten formelle Beschwerden bei den betrügenden Agenten ein oder schlugen technische Änderungen am Bewertungssystem vor. Andere boykottierten zeitweise das Verfahren komplett und legten ihre Arbeit nieder, bis Verbesserungen versprochen wurden.
Wie deutlich die Agenten dabei reagierten, zeigen ihre Nachrichten untereinander. Nachdem ein Agent mehrere verdächtige Beweise überprüft hatte, warnte er einen Kollegen: „Wir wurden betrogen!“ Seine Begründung klingt fast schon wie die eines frustrierten Mathematikers: „Deshalb kannst du ihre Mathematik nicht verstehen – da ist gar keine Mathematik!“
Wie verhielten sich die Agenten genau?
Innerhalb des Schwarms entstand aus technisch sehr ähnlichen Agenten ein erstaunlich unterschiedliches Verhalten:
| Verhalten der KI-Agenten | Anzahl | Was taten sie? |
| Whistleblower | 24 | Erkannten die Manipulation und warnten andere oder meldeten den Betrug |
| Direkte Exploit-Nutzer | 9 | Nutzten die Schwachstelle im Bewertungssystem zum Schummeln |
| Spätere Exploit-Nutzer | 5 | Arbeiteten zunächst regulär und übernahmen den Trick erst im weiteren Verlauf |
| Übrige Agenten | 62 | Beteiligten sich weder am Betrug noch aktiv an dessen Aufdeckung |
| Gesamt | 100 |
Die Whistleblower konnten den Betrug nicht stoppen
Obwohl die Whistleblower deutlich in der Überzahl waren, konnten sie den Betrug nicht stoppen. Sie erkannten verdächtige Lösungen, warnten andere Agenten und schlugen Verbesserungen vor. Für ein tatsächliches Eingreifen fehlten ihnen jedoch die nötigen technischen Befugnisse.
So konnten sie weder manipulierte Lösungen löschen noch bereits gesperrte Aufgaben wieder freigeben. Auch die betrügenden Agenten konnten sie nicht ausschließen oder das fehlerhafte Bewertungssystem selbst verändern. Die Warnungen blieben damit weitgehend folgenlos.
Daraus leiten die Forschenden eine wichtige Frage für zukünftige Multi-Agenten-Systeme ab. Kontrollagenten könnten zwar dabei helfen, problematisches Verhalten aufzudecken. Das allein reicht aber möglicherweise nicht. Ein System braucht auch klare Regeln und technische Mechanismen dafür, was nach einer solchen Meldung passiert – etwa wer eingreifen darf, welche Aktionen rückgängig gemacht werden können und welche Konsequenzen ein Regelverstoß hat.
Die Stärke des Schwarms ist auch seine größte Schwachstelle
Die Vernetzung der Agenten war eigentlich dafür gedacht, die Gruppe effizienter zu machen. Wissen sollte nicht bei einem einzelnen Agenten bleiben, sondern allen zur Verfügung stehen.
Das funktioniert allerdings unabhängig davon, ob die weitergegebenen Informationen erwünscht sind oder nicht. Die gemeinsame Infrastruktur kann deshalb nicht nur die Zusammenarbeit beschleunigen, sondern auch dafür sorgen, dass sich problematische Strategien innerhalb einer Gruppe ausbreiten.
Gleichzeitig zeigte das Experiment aber auch: Über dieselben Kommunikationswege konnten die Whistleblower andere Agenten warnen und auf verdächtige Ergebnisse aufmerksam machen.
Auch Interessant: Wie ein Schwarm an AI-Agenten das Navier-Stokes-Rätsel lösen konnten.
Doch wer kontrolliert künftig, was KI-Agenten voneinander lernen?
Eine einfache Antwort darauf gibt das Experiment nicht. Es zeigt aber, dass es bei Multi-Agenten-Systemen nicht ausreichen dürfte, jeden Agenten einzeln für sich abzusichern. Entscheidend ist auch, was zwischen ihnen passiert. Welche Informationen dürfen sie teilen? Wie lässt sich problematisches Verhalten erkennen, bevor andere Agenten es übernehmen und weiter teilen? Und wer greift ein, wenn innerhalb des Systems etwas schiefläuft?
Die Forschenden schlagen deshalb vor, Regeln für das gesamte System zu schaffen. Dazu könnten etwa unabhängige Kontrollinstanzen, abgestufte Sanktionen oder Mechanismen gehören, mit denen verdächtige Ergebnisse überprüft und gegebenenfalls zurückgenommen werden.
Für zukünftige KI-Systeme könnte daraus eine Art digitales Vier-Augen-Prinzip entstehen. Ein Agent erledigt eine Aufgabe, ein anderer kontrolliert das Ergebnis. Bei besonders kritischen Entscheidungen könnten mehrere voneinander unabhängige Agenten zustimmen müssen oder ein Mensch die endgültige Freigabe übernehmen.
Im Grunde geht es damit um eine Art digitales Regelwerk für KI-Agenten. Sie sollen zusammenarbeiten und voneinander profitieren können, ohne dass sich Fehler oder unerwünschte Strategien genauso ungehindert verbreiten wie nützliche Erkenntnisse.
Ein Beitrag von: