KI-Qualitätskontrolle: Mit weniger Trainingsdaten schneller in die Produktion
KI-basierte Qualitätskontrolle kann Fehler schnell und zuverlässig erkennen. Nachteil: der Aufwand für die Trainingsdaten ist sehr hoch. Im Beitrag werden zwei Ansätze gezeigt, die den Aufwand deutlich reduzieren.
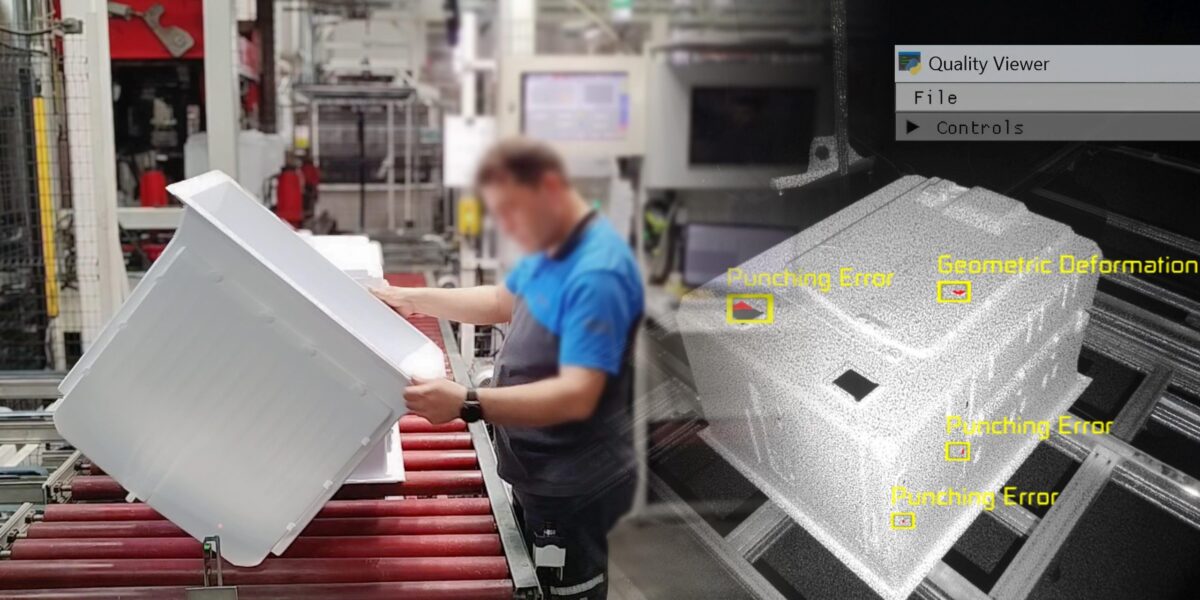
Qualitätskontrolle in der Kühlschrankproduktion: Ein 3D-Modell des Kühlschrankinnenkörpers wird mit dem CAD-Modell verglichen. So lassen sich Abweichungen vom Soll präzise erkennen und bewerten.
Foto: Fraunhofer IGD
Künstliche Intelligenz (KI) und Machine Learning (ML) haben die Möglichkeiten zur Qualitätskontrolle und Steigerung der Produktivität in der Produktion verschoben. Doch ihre Einführung geht mit gewissen Anforderungen einher, beispielsweise der Verfügbarkeit von Trainingsdaten in ausreichendem Umfang und in hinreichender Güte beziehungsweise Aussagekraft. Das erschwert in vielen Fällen die wirtschaftliche Einführung dieser Lösungen, so dass manche Unternehmen gänzlich darauf verzichten. Jedoch muss die Einführung nicht unangemessen kostenintensiv sein. Dieser Beitrag diskutiert die Herausforderungen, speziell für bild- und modellbasierte Aufgaben, und zeigt Lösungen zum wirtschaftlichen Einsatz von ML in der Produktion sowie Anwendungsbeispiele.
Inhaltsverzeichnis
- 1. Einführung: KI, ML und die Bedeutung von Trainingsdaten
- 2. Herausforderungen im industriellen Kontext: wirtschaftliche Erstellung von Trainingsdaten für bild- und modellbasierte KI-Anwendungen
- 3. Wirtschaftlicheres Lernen durch Training nur mit Bildern von Gutteilen und Trainingsdatensynthese
- 4. Anwendungen
- 5. Zusammenfassung
- Autoren:
1. Einführung: KI, ML und die Bedeutung von Trainingsdaten
Künstliche Intelligenz ist ein Oberbegriff. Darunter fallen die symbolische, logische KI sowie die statistische, sub-symbolische KI. Beide Formen sind bereits mehrere Jahrzehnte alt, wobei die logische KI noch weiter zurückreichende Wurzeln hat. Darunter fallen die klassischen regel- oder logikbasierten „Expertensysteme“, die zum Beispiel in Prolog oder LISP programmiert wurden. Bekanntes Wissen wurde also in Regeln in Programmcode „übersetzt“, über die die Systeme dann Auswertungen gemacht haben.

Im Gegensatz dazu werden beim Maschinellen Lernen künstliche neuronale Netze trainiert – das Netz „lernt“, es entsteht ein KI-Modell. Beim überwachten Lernen werden bekannte Paare von Eingangsinformationen/-mustern und zugehöriger „Aussage“ (Klasse) genutzt, um das Netz zu trainieren. Die Menge dieser Paare wird Trainingsdaten genannt.
Bei ähnlichen Eingangsmustern soll das neuronale Netz in der Lage sein, diese der „richtigen“ Klasse zuzuordnen beziehungsweise als unbekannt oder – je nach Anwendungsfall – nicht in Ordnung zu erkennen. Ziel des nicht überwachten Lernens ist es, neuronale Netze Mengen von ähnlichen Mustern (Cluster) in hochdimensionalen Räumen erkennen zu lassen. Den Clustern kann anschließend eine Bedeutung beigemessen werden. Im weiteren Verlauf des Artikels konzentrieren wir uns auf überwachtes Lernen.
Um die Notwendigkeit von Trainingsdaten zu verstehen, stellen wir kurz die Analogie zum Lernen beim Menschen vor. Als Kinder lernen wir die „Bezeichnungen“ von Formen und Farben (Attributen), in dem uns unsere Eltern Beispiele zeigen und die „Bezeichnungen“ nennen. In der nachstehenden Abbildung ist ein Beispiel gegeben. Die Mutter zeigt ihrem Kind einen roten Roboter. Allein daraus ließe sich nicht lernen, zwischen dem „Ding“ Roboter und der Farbe Rot zu unterscheiden. Viele verschiedene Dinge müssen Kindern gezeigt werden, damit sie verstehen, das Attribut „Farbe“ von der Form zu trennen. Bis das Kind es richtig gelernt hat, ist es nötig, zu sagen: „das ist ein roter Ball“ oder „das ist ein rotes Auto“.
Ähnlich verhält es sich mit dem Lernen von Bezeichnungen für Dinge: Kindern müssen viele unterschiedliche Roboter gezeigt werden, um zu lernen, dass all diese Varianten zu der „Klasse“ Roboter gehören – auch unterschiedliche Blickwinkel sind nötig, um diese „Ansichten“ mit dem Konzept Roboter zu assoziieren und „abzuspeichern“. Es sind also unzählige Objekte – oder Bilder davon – nötig, um die Bezeichnungen von Dingen zu lernen. Weitere Beispiele sind nötig, um bspw. zu lernen, ob ein Ding kaputt ist. Überwachtes Lernen ist also learning by example. Im Unterschied dazu lernen wir Rechnen, in dem wir „die Rechenregeln“ lernen – das entspricht einer symbolischen KI.

Die Beispiele und Bilder sowie deren Bezeichnungen werden beim Maschinellen Lernen als Trainingsdaten bezeichnet. Um einem Computer das Sehen beizubringen, reicht es nicht, nur Bilder zu zeigen, sondern die Bezeichnungen oder Eigenschaften müssen beim überwachten Lernen mit in das Training einbezogen werden. Dazu müssen diese bekannt sein, das heißt Bilder müssen annotiert werden, damit Computer lernen können, was darauf zu sehen ist. Dies gilt auch für andere Sensorsignale, beispielsweise Zeitreihen von Messwerten, die an Maschinen abgenommen werden und die mittels ML analysiert werden sollen – wir konzentrieren uns an dieser Stelle aber auf Bilder und Modelle, genauer 3D-Modelle, als Gegenstand des Trainings oder der Analyse.
2. Herausforderungen im industriellen Kontext: wirtschaftliche Erstellung von Trainingsdaten für bild- und modellbasierte KI-Anwendungen
Im industriellen Kontext, in der Fertigung, ist die sogenannte industrielle Bildverarbeitung seit Jahrzehnten etabliert. Sie wird typischerweise eingesetzt, um Beschädigungen von Produkten während des Produktionsprozesses (zum Beispiel Kratzer, Verformungen, fehlende Stanzungen, Verschmutzung, etc.), falsche Lage von Bauteilen in Zusammenbauten oder ähnliches automatisiert zu entdecken. Wurden in der klassischen industriellen Bildverarbeitung Algorithmen konfiguriert, Regeln definiert und Parameter bestimmt, um unter variablen Umgebungsbedingungen Fehler robust erkennen zu können, was ein aufwendiger Prozess ist, so wird dies heute zunehmend durch ML aus Bildern ersetzt. Der Aufwand verschiebt sich dadurch hin zur Generierung guter Trainingsdaten sowie dem Trainieren von KI-Modellen und wird im Idealfall mit besseren und flexibleren Systemen zur Bilderkennung belohnt.
Jedoch, wie aufwendig kann die Erzeugung von Trainingsdaten sein und warum steht sie manchmal der ökonomischen Einführung im Wege?
Damit ein Rechner per ML lernen kann, Fehler auf Objekten oder in Zusammenbauten zu erkennen, muss das entsprechende neuronale Netz trainiert werden mit:
- einer Vielzahl (typisch mehrere Tausend) von Bildern von Gutteilen (i.O.-Teile)
- einer Vielzahl von Bildern mit Schlechtteilen (n.i.O.-Teile)
- beides am besten unter variablen Beleuchtungsbedingungen, damit das Netz lernt, von Beleuchtungseffekten in den Bildern zu abstrahieren und Fehler unabhängig davon zu erkennen – was Menschen ja auch meist gut gelingt
Nun ist es in vielen Produktionsprozessen relativ einfach, eine Kamera zu platzieren und Bilder von Produkten gegebenenfalls jeweils nach verschiedenen Bearbeitungsschritten zu machen. 99 % und mehr dieser Bilder werden Produkte zeigen, die keine Fehler aufweisen. ML braucht aber auch Bilder von fehlerhaften Teilen. Es wird also sehr lange dauern bis in einem Produktionsprozess die Menge von fehlerhaften Bauteilen anfällt, mit der ein neuronales Netz dann trainiert werden kann, um zwischen gut und schlecht zu unterscheiden. Beim Training muss dem Netz die Information „Gutteil“ oder „Schlechtteil“ mitgegeben werden. Sollen verschiedene Fehlerklassen erkannt werden, müssen diese in den Bildern kenntlich gemacht und mit der entsprechenden Bezeichnung gelernt werden – die Bilder müssen annotiert werden, was oft manuell erfolgen muss.

Zwei Aspekte machen also diese Art der Erstellung von Trainingsdaten schwierig und unökonomisch: erstens in eingespielten Produktionsprozessen gibt es verhältnismäßig wenige Fehler und zweitens müssen die Bilder annotiert werden.
Das Annotieren von Bildern kann durch Dienstleister geschehen, was entsprechende Kosten nach sich zieht – dabei können sich ebenfalls Fehler einschleichen. Die Vergabe an Dienstleister führt zu Wartezeiten bis ein System eingeführt werden kann oder es auf neue Fehlerarten adaptiert ist.
In Extremsituationen kann es sein, dass eine Produktion temporär angehalten werden muss, um Aufnahmen von Bauteilen zu machen oder Systeme zu aktualisieren.
Geht es nicht nur um die Defekterkennung an Oberflächen, sondern auch um das Erkennen des korrekten Zusammenbaus von komplexen Baugruppen, müssen die Teile aus unterschiedlichen Perspektiven heraus erkannt werden – ein Bild pro Teil reicht nicht mehr aus. Genauso wie Kinder lernen, Roboter nicht nur von vorne zu erkennen, um bei dem obigen Beispiel zu bleiben, so müssen künstliche neuronale Netze Bilder aller Objekte aus unterschiedlichen Ansichten lernen – das erhöht den Aufwand beim Training. Darüber hinaus müssen Bilder zum korrekten und inkorrekten Zusammenbau vorliegen. Und das alles unter verschiedenen Umgebungsbedingungen, zum Beispiel Lichtsituationen, denn das System soll nicht nur dann funktionieren, wenn diese so sind wie auf den Bildern, die zum Training verwendet wurden. Die Kosten für die für das Training benötigte Rechenzeit können ein weiterer Faktor sein, der die Einführung von ML-gestützten Verfahren unwirtschaftlich macht.
Zusammenfassend können wir festhalten, dass es folgende Herausforderungen gibt:
- das Generieren und Annotieren von Trainingsdaten
Aufnehmen und Annotieren von Bildern von Gut- und Schlechtteilen kann bei zum Beispiel 50 Prüfmerkmalen Kosten im 5-stelligen Bereich mit sich bringen. - die Verfügbarkeit von Erfahrungswissen im Umgang mit ML-Tools oder Toolboxen zur optischen Qualitätskontrolle
Es existiert eine Vielzahl von Anbietern und Möglichkeiten. Die Auswahl geeigneter Tools und Netztopologien für bestimmte Aufgaben sowie der Hardware- und Trainingszeitbedarf benötigen Expertise und Erfahrungswissen. Diese sind nicht in jedem Unternehmen verfügbar. - Aufwand für Training (Zeit, HW-Kosten)
Das Trainieren komplexer „tiefer neuronaler Netze“ (Deep Neural Networks – DNNs) kann viele Stunden bis zu Tagen in Anspruch nehmen und entsprechende Kosten für die Nutzung geeigneter Hardware erzeugen. Wird dazu Cloud-Hardware genutzt, können Bedenken hinsichtlich eines sicheren Austauschs vertrauenswürdiger Daten existieren. - Güte (Zuverlässigkeit bei der Fehlererkennung)
Die Güte von KI-Modellen wird anhand sog. Testdaten evaluiert. Neben der Wahl geeigneter Trainingsdaten ist die Zusammenstellung von Testdaten wichtig, um eine zuverlässige Aussage bezüglich der Güte des trainierten Modells treffen zu können. Ein Modell soll möglichst alle Fehler erkennen, aber nicht fälschlicherweise (zu viele) Gutteile als schlecht klassifizieren oder umgekehrt. Letzteres ist auf jeden Fall unerwünscht, aber auch unnötiger „Ausschuss“ ist zu vermeiden. - Notwendige HW für die Ausführung des KI-Modells in der Prozesszeit von Fertigungsschritten bei Inline-Überwachung
In der optischen Qualitätssicherung sollen Prozesse und Produkte oft während der Fertigung beobachtet werden, denn je früher Fehler erkannt werden, desto kostengünstiger sind sie zu beheben. Große KI-Modelle erfordern für kurze „Ausführungszeiten“ (Inferenzzeiten – also die Zeit bis aus einem Input eine Aussage abgeleitet ist) entsprechende Hardware, die u.U. direkt an den Produktionsmaschinen nicht zur Verfügung steht. Wünschenswert sind kompakte KI-Modelle mit hoher Güte, die auf kostengünstiger Hardware schnell ausgeführt werden können.
3. Wirtschaftlicheres Lernen durch Training nur mit Bildern von Gutteilen und Trainingsdatensynthese
Die genannten Herausforderungen adressierend, entwickeln wir zwei alternative Herangehensweisen:
- das Training von KI-Modellen mit Bildern von Gutteilen
- die Synthese von Trainingsdaten aus CAD-Modellen
3.1 Training von KI-Modellen mit Bildern von Gutteilen
Wie geschildert, ist es viel einfacher, Bilder von Gutteilen zu machen, als abzuwarten, bis in der Produktion unbeabsichtigt Schlechtteile entstehen, diese aufzunehmen und in den Trainingsprozess zu integrieren.
Für den Trainingsprozess benötigen wir typischerweise nur eine dreistellige Anzahl von Bildern, die den Raum der im Normbereich liegenden Toleranzen möglichst abdecken sollten. Wir verwenden vortrainierte KI-Modelle und trainieren sie mit diesen Bildern nach. Das Training erfolgt sehr schnell, beispielsweise haben wir für die Anomalieerkennung auf Filzstücken für 70 Gutbeispiele nur 23 s auf einer Nvidia A40 GPU gebraucht – bei einer Bildauflösung von 490 x 490 Pixel. Die Erkennungsrate betrug in diesem Beispiel 97.8%.
Damit ist es uns gelungen, folgende Vorteile und Kundennutzen zu realisieren:
- geringer Aufwand für die Trainingsdatenerhebung
- beschleunigte Einführungsphase für das System zur optischen Anomalieerkennung
- schnelle Inferenzzeiten durch kompakte ML-Modelle für in-process Qualitätsprüfung – Inferenzzeit ab ca. 10ms
- günstige Hardware – Edge-Lösungen bzw. lokale Ausführung ist möglich
- hohe Güte, die im Einsatz durch Nachtraining – auch mit Schlechtbildern – weiter gesteigert werden kann
3.2 Synthese von Trainingsdaten aus CAD-Modellen
CAD-Modelle stehen oft in Unternehmen zur Verfügung lange bevor die Produktion anläuft. Warum also nicht die CAD-Modelle nutzen, um Systeme zur optischen Qualitätskontrolle zu trainieren, so dass diese ab Produktionsbeginn eingesetzt werden können?
Das ist ein weiterer Vorteil der Trainingsdatensynthese aus CAD-Daten – außer der leichteren und kosteneffizienteren Generierung der Trainingsdaten einschließlich Annotationen, die entweder aus Metadaten der CAD-Modelle (etwa Teilebezeichnung) abgeleitet oder aus dem Syntheseprozess selbst (beispielsweise Fehlerklassen) generiert werden können.
So werden verschiedene Applikationen möglich:
- Das Erkennen von Oberflächenfehlern / -deformationen
- Das Erkennen von falschen Zusammenbauten
Nicht nur das automatische Erkennen von Fehlern in der Assemblierung wird möglich, Werker können basierend auf gelernten Zusammenbauten auch geschult werden bzw. ihnen kann am Band die korrekte Montage mittels XR eingeblendet werden. - Fertigungstoleranzen können in die digitale CAD-Geometrie eingebracht und mitgelernt werden
Für alle drei genannten Anwendungen müssen aus den CAD-Modellen Bilder erzeugt werden, die geeignet sind, aufgabengerechte KI-Modelle zu trainieren. Dazu ist weit mehr nötig, als Bildschirmfotos von den auf dem Monitor dargestellten CAD-Modellen zu erzeugen, denn diese würden weder über entsprechende Oberflächenfehler verfügen noch die Beleuchtungssituation in der Fertigung auch nur näherungsweise darstellen – diese Diskrepanz wird als domain gap bezeichnet.

Um Computer in die Lage zu versetzen, den korrekten Zusammenbau des Systems Bremse-Radaufhängung-Feder-Dämpfung erkennen zu können, müssen von allen CAD-Modellen Bilder aus unterschiedlichen Perspektiven gemacht und trainiert werden. Wir haben den Prozess automatisiert – Menschen ihn machen zu lassen wäre sehr teuer.

Darüber hinaus müssen die Bauteile mit unterschiedlichen Materialien versehen werden, von denen ebenfalls automatisiert Bilder gemacht werden, die in die Menge der Trainingsdaten eingehen. Schließlich werden die Bauteile der Baugruppe in unterschiedlichen Konfigurationen auf verschiedenen Hintergründen abgebildet (siehe Bild 5 re.), damit der Computer sie unabhängig voneinander erkennen kann – Bilder vom korrekten Zusammenbau werden aus dem Assembly-Modell aus dem CAD- oder PLM-System ebenfalls trainiert. In allen Schritten werden Metadaten automatisch extrahiert und in das Training einbezogen. So kann das trainierte KI-Modell Bauteile in der Szene erkennen und Aussagen darüber treffen, ob ihre Position und Orientierung in der Baugruppe korrekt ist. Falls dies nicht der Fall ist, können Mitarbeitende an der Assembly Line Hinweise erhalten, was wie zu ändern ist. Auch können sie basierend auf dieser Technologie im Vorfeld bereits in der korrekten Assemblierung geschult werden.
Vergleichbar zu dem gerade beschriebenen Prozess wird bei der Trainingsdatensynthese für Bauteile mit Oberflächenfehlern vorgegangen.
Dabei gibt es drei Ansätze:
- eine Manipulation des Bildes des CAD-Modells
- die Manipulation einer Textur auf dem 3D-Modell, bevor ein Bild für die Trainingsdaten gemacht wird
- eine echte Geometriemanipulation des 3D-CAD-Modells, bevor ein Bild gemacht wird
Die dritte Methode ist in der Praxis noch recht selten, bietet aber auch die Möglichkeit, Fertigungstoleranzen oder Abnutzungserscheinungen, zum Beispiel bei Werkzeugen, vor dem Training von KI-Modellen in die CAD-Geometrie einzuprägen – ein aktuelles Forschungsthema, um KI-gestützte optische Qualitätskontrollsysteme weiter zu verbessern.
4. Anwendungen
In diesem Abschnitt werden oben angesprochene Anwendungsbeispiele ausführlicher beleuchtet.

Visuelle Endkontrolle von Gasgenerator-Schnittstellen
Gasgenerator-Schnittstellen für Airbags, sogenannte Airbagzünder, sind sicherheitsrelevante Bauteile, die nur einmalig funktionieren. Sie können also zum Test nicht „ausprobiert“ werden und wurden früher durch Inaugenscheinnahme von Menschen visuell geprüft – die Prüfung fand chargenweise statt. Die Prüfung sollte automatisiert werden und jeder Zünder sollte möglichst in Prozesszeit überprüft werden, um Fehler früh zu erkennen und Probleme in der Produktion schnell beheben zu können, ohne dass weitere Produkte davon betroffen werden.
An dieser Stelle wurde eine Lösung erarbeitet, die später das Trainieren nur mit „Gutdaten“ inspiriert hat. Auf der Basis von Bildern von i.O.-Produkten wird ein Durchschnittsmodell errechnet. Die Ausführungszeit liegt bei 120 ms und ist damit prozessgerecht. Die Erkennungsrate beträgt 99,999%. Die Lösung ist mittlerweile an internationalen Standorten im Einsatz.
Überwachung des Qualifikationsprozesses von Mikrochips
Als Qualifikationsprozess von Mikrochips wird die Prüfung auf Funktionalität, Leistungsfähigkeit und Zuverlässigkeit unter verschiedenen Bedingungen bezeichnet. Es existierten viele Teilaufnahmen von Chipoberflächen, aber es gab nur sehr wenige Negativbeispiele (Bilder von n.i.O. Chips). So wurde das Verfahren des Lernens nur mit „Gutdaten“ entwickelt und evaluiert. Das resultierende KI-Modell erkennt, wo es Abweichungen vom OK-Zustand gibt. Die Inferenzzeit beträgt weniger als 100 ms, so dass eine nahtlose Integration in den bestehenden Aufnahmeprozess möglich war. Das Training kann on-premise stattfinden – die Auswertung ebenso.
Überwachung Montageprozess von Ultraschallsonden
Ultraschallsonden werden getestet, in dem unter anderem “in die Luft geschallt” wird. Für das geschulte Auge entsteht dabei ein charakteristisches Rauschbild. Gewisse Muster weisen auf einen Montagefehler hin. Dieser Prozess sollte durch automatische visuelle Kontrolle abgelöst werden, um unabhängiger von der Erfahrung von Menschen zu werden und konsistente Ergebnisse zu erzielen, unabhängig von der Tagesform eines Menschen. Im Bildmaterial von 38.000 Aufnahmen existierten nur 13 Aufnahmen von n.i.O.-Produkten. Die Datenaufbereitung erfolgte gemeinsam mit Domänenexperten. Wieder kam der Ansatz des Lernens nur mit „Gutdaten“ zum Einsatz. Das so trainierte KI-Modell identifiziert und lokalisiert Abweichungen vom OK-Zustand. Der Kunde hat das Verfahren standardmäßig in den Prüfprozess aufgrund der hohen Ausführungsgeschwindigkeit (<100ms) und Erkennungsrate integriert.
Zusammenbaukontrolle und Werkerunterstützung
Zur Erkennung der Position und Orientierung von Bauteilen, der sogenannten Pose, innerhalb einer Baugruppe kommt der in Abschnitt 3.2 beschriebene Ansatz der Trainingsdatensynthese aus CAD-Modellen zum Einsatz. An der Assembly Line sind typischerweise mehrere Kameras montiert, um komplexe Baugruppen aus unterschiedlichen Perspektiven zu erfassen. In diesen Bildern identifizieren wir die einzelnen Bauteile und prüfen, ob ihre Pose mit der im CAD-Zusammenbaumodell definierten übereinstimmt. Dieser Prozess läuft automatisch ab. Wird erkannt, dass ein Bauteil falsch orientiert wurde oder gar ganz fehlt, erfolgt ein Hinweis an das Personal. Zur Korrektur wird in einer Augmented Reality-Anwendung die korrekte Pose eingeblendet und so visuell kommuniziert, was zu tun ist, um den Fehler zu beheben. Wird das System frühzeitig mit CAD-Daten trainiert, kann es bereits bei Produktionsbeginn eingesetzt werden. Es lässt sich auch für die Schulung von Mitarbeitern nutzen.
Schadenserfassung im Umformprozess
Für die Bildverarbeitung in industriellen Anwendungen ist eine geeignete Bildgebung für gute und schnelle KI-Modelle entscheidend. Wenn Bauteile Anomalien aufweisen, diese in Bildern der Bauteile aber nicht erkennbar sind, kann eine Bildverarbeitung keine brauchbaren Ergebnisse liefern – eigentlich eine Selbstverständlichkeit. Daher entwickeln wir dedizierte Bilderfassungssysteme, bestehend aus Kameras, Beleuchtung und Datenverarbeitung.

Ein Beispiel ist ein System, das für ein Folgeverbundwerkzeug in einem Umformprozess entwickelt wurde. In Prozesszeit – mit bis zu 400 Hüben pro Minute – werden 18 Bilder von dem umgeformten Blech aufgenommen, wobei die Lichtpositionen variiert werden, d.h. innerhalb von 150 ms nehmen wir 18 Bilder auf. Aus diesen Bildern wird für jedes Objekt per Photometric Stereo eine Normalenkarte rekonstruiert – die Geschwindigkeit erreichen wir durch eine eigene Implementierung des Verfahrens. Die Normalenkarten werden auf Fehler verschiedener Klassen hin analysiert (siehe Bild 7 rechts).
5. Zusammenfassung
Die automatische optische Qualitätskontrolle hat durch Machine Learning in den letzten Jahren deutliche Verbesserungen erfahren, insb. dort wo sich variierende Bedingungen vorfinden. Bildbasiertes Machine Learning geht mit hohen Anforderungen an die Trainingsdaten einher. Ihre Zurverfügungstellung ist oft mit hohen Kosten verbunden, die den Einsatz von ML unwirtschaftlich werden lassen können.
Dieser Beitrag zeigt unter anderem wie durch Bildsynthese aus 3D-Modelldaten und Training mit Bildern nur von Gutdaten die Einführung von ML-basierten Verfahren zur optischen Qualitätssicherung wirtschaftlicher gestaltet werden kann. Trotz Reduktion des Aufwands kann dabei eine hohe Vorhersagegüte erreicht werden. Mit synthetisch generierten Daten trainierte Systeme können früher, nämlich schon bei Produktionsanlauf, eingesetzt werden – ein mehr als willkommener Nebeneffekt. Kompakte KI-Modelle reduzieren die Anforderungen an Hardware, um die Inferenz in Prozesszeit durchführen zu können, und ermöglichen in-process Qualitätsbeobachtung.
Autoren:
- André Stork, Pedro Santos und Holger Graf, Fraunhofer-Institut für Graphische Datenverarbeitung, Darmstadt
- Mario Aehnelt, Fraunhofer-Institut für Graphische Datenverarbeitung, Rostock
- Chris Schinko, Fraunhofer Austria, Graz